-
KI hat ein verzerrtes Bild vom Menschen
Können Sprachmodelle menschliche Befragungsteilnehmer ersetzen? Eine internationale Studie in Nature Human Behaviour kommt zu einem ernüchternden Ergebnis: Künstliche Intelligenz kann zwar manche statistischen Zusammenhänge menschlicher Eigenschaften nachbilden, unterschätzt jedoch die tatsächliche Vielfalt menschlicher Einstellungen und Präferenzen. Die Forschenden um Fadong Chen verwendeten Befragungsdaten von 67.201 Menschen aus 74 Ländern. Anschließend ließen sie verschiedene Sprachmodelle Antworten dieser Personen simulieren. Untersucht wurden sechs wirtschaftlich relevante Eigenschaften: Risikobereitschaft, Geduld, Vertrauen, Altruismus sowie positive und negative Reziprozität. Dabei zeigte sich ein systematisches Problem. Die simulierten Antworten waren häufig homogener als die tatsächlichen menschlichen Antworten. Individuelle Unterschiede wurden eingeebnet, extreme Ausprägungen unzureichend abgebildet.
Das könnte dich ebenfalls interessieren
KI: Sprachmodelle bevorzugen, was es schon gibt
Den Konservativen sei Dank: Europa und die USA losen bei Batterien ab
Kokablätter auf geopferten Inka-Lamas entdeckt
-
KI: Warum echte Fragen KI-Systeme besser testen als künstliche
Viele KI-Anwendungen beantworten Fragen nicht ausschließlich aus ihrem Trainingswissen. Sie durchsuchen zunächst eine Dokumentensammlung und formulieren auf Grundlage gefundener Texte eine Antwort. Das Verfahren heißt RAG: „Retrieval-Augmented Generation“, also durch Informationssuche ergänzte Textgenerierung. Eine Untersuchung verglich 1.851 automatisch erzeugte Testfragen mit 322 echten Fragen von Studierenden an ein universitäres Informationssystem. Synthetische Fragen waren durchschnittlich 15,7 Wörter lang, echte nur 6,8. Die künstlichen Fragen verteilten sich über 165 Quellen; echte Nutzer benötigten nur 53 und konzentrierten sich auf wenige Themen. Ein Suchverfahren, das in künstlichen Tests besonders gut abschnitt, brachte bei echten Fragen keinen entsprechenden Vorteil, verursachte aber teils längere Wartezeiten. Daraus folgt: Automatisch erzeugte Fragen sind nützlich, sollten aber um…
Das könnte dich ebenfalls interessieren
Kokablätter auf geopferten Inka-Lamas entdeckt
Jülicher KI-JUPITER erreicht Rekord-Rechenleistung
Wer löste da Quantenphysik? Mensch, KI, beide?
-
Polnische KI sucht kleiner – und soll trotzdem besser sein
Ein Forschungsteam aus Polen setzt bei Künstlicher Intelligenz nicht auf immer größere Modelle, sondern auf kleinere Spezialisten. Das Ośrodek Przetwarzania Informacji, kurz OPI, hat mit PolDense mehrere KI-Modelle entwickelt, die gezielt Informationen in polnischsprachigen Texten finden sollen. Nach Angaben des Instituts schneiden sie dabei besser ab als vergleichbare ausländische Modelle – obwohl sie rund zehnmal kleiner sind. Solche Modelle sind keine klassischen Chatbots. Ihre Aufgabe besteht vor allem darin, in großen Textsammlungen passende Informationen zu finden. Genau solche Systeme stecken heute hinter vielen KI-Suchen, Chatbots und sogenannten RAG-Anwendungen, bei denen eine KI zunächst Dokumente durchsucht und daraus anschließend eine Antwort formuliert.
-
Max-Planck-Forscher zu KI: “Neu ist die Qualität der Autonomie”
Neue KI-Sprachmodelle können Cyberangriffe nicht nur sprachlich vorbereiten, sondern technische Teilschritte zunehmend eigenständig ausführen. Darauf weist das Max-Planck-Institut für Sicherheit und Privatsphäre in Bochum hin. Gemeint sind sogenannte agentische Modelle wie Claude Mythos von Anthropic oder ChatGPT-5.5 von OpenAI. Sie können Aufgaben planen, Werkzeuge einsetzen, Ergebnisse prüfen und Fehlversuche in weiteren Schritten korrigieren. Der Informatiker Prof. Dr. Thorsten Holz beschreibt den Unterschied zu früheren Modellen mit der Qualität der Autonomie. Bisherige Systeme konnten etwa Phishing-Texte erstellen oder bei der Analyse von Code helfen. Neuere Modelle sind stärker darauf ausgelegt, mehrstufige Aufgaben selbständig zu bearbeiten. Für die Cybersicherheit ist das relevant, weil Angriffe häufig aus wiederholtem Testen, Anpassen und erneutem Ausführen…
Das könnte dich ebenfalls interessieren
Den Konservativen sei Dank: Europa und die USA losen bei Batterien ab
Wer löste da Quantenphysik? Mensch, KI, beide?
Warum kennen wir die Klitoris noch immer so schlecht?
-
KI liest Zahlen aus Studien – Jülicher System automatisiert Datenauswertung
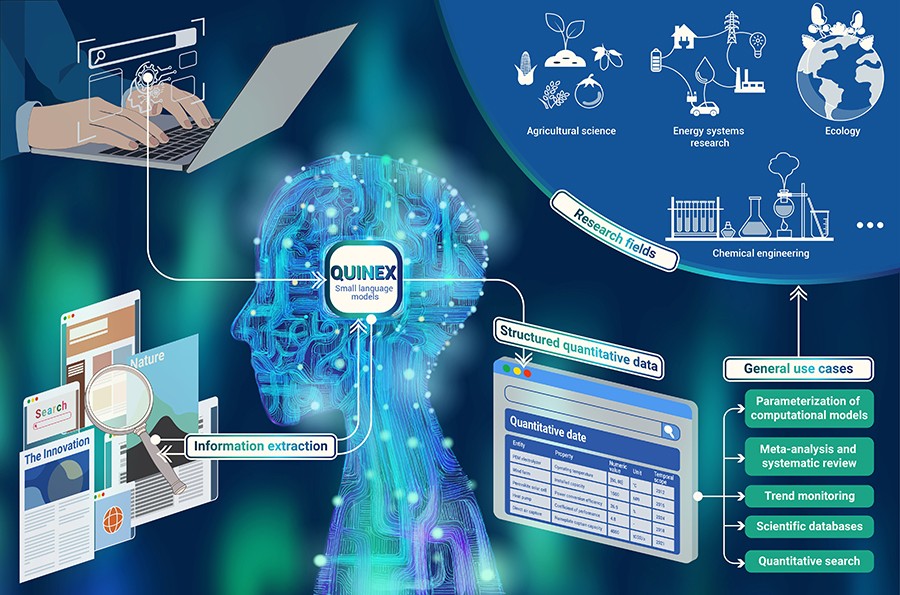
orschende des Forschungszentrums Jülich haben ein KI-System entwickelt, das quantitative Daten aus wissenschaftlichen Texten automatisch extrahiert und strukturiert aufbereitet. Das Framework mit dem Namen Quinex („Quantitative Information Extraction“) soll die Auswertung großer Mengen wissenschaftlicher Literatur erleichtern. Wissenschaftliche Publikationen enthalten zahlreiche Zahlenwerte, etwa zu Wirkungsgraden, Kosten oder Messdaten. Diese Informationen sind häufig im Fließtext eingebettet und bislang nur mit erheblichem Aufwand manuell zugänglich. Quinex setzt an diesem Punkt an: Das System identifiziert Zahlen in Texten, ordnet ihnen passende Einheiten zu und erkennt den jeweiligen Kontext, etwa was gemessen wurde sowie wann, wo und unter welchen Bedingungen.
Das könnte dich ebenfalls interessieren
KI sagt Pflanzen voraus

Wenn Zellen ihren Abfall nicht loswerden

Weniger Geld durch Lobbyarbeit
-
Richard Sutton: Warum KI erst am Anfang steht
Richard S. Sutton, einer der Mitbegründer des Reinforcement Learning und seit Jahrzehnten eine zentrale Figur der KI-Forschung, stellt in seinem YouTube-Vortrag „The Future of AI“ eine unbequeme These auf: So beeindruckend heutige KI-Systeme auch wirken – wissenschaftlich stehen wir seiner Ansicht nach noch am Anfang. Sprachmodelle seien vor allem mit menschlichen Daten gefüttert und könnten dieses Wissen geschickt wiedergeben, doch sie lernten nicht wirklich weiter und hätten keine eigenen Ziele. Der nächste große Schritt, so Sutton, werde erst kommen, wenn KI-Systeme nicht nur Texte vorhersagen, sondern wie eigenständige Agenten durch Erfahrung lernen, handeln, Rückmeldung bekommen und ihr Verhalten anpassen. Wir haben uns seinen Vortrag angeschauen, und berichten, worum es geht.…
Das könnte dich ebenfalls interessieren

Longread: Wird künstliche Intelligenz uns alle töten?
Alle Reformen sind sinnlos. Jetzt, am Vorabend des KI-Zeitalters
Felix Nmecha: Christfluencer in der Kabine?